04.3.1 应用的基本条件
趋势卡方检验的核心目的,是检验一个二分类观察指标(如:缓解/未缓解)的阳性率,是否随着另一个有序自变量(如:靶向药物浓度 低/中/高)等级的升高而呈现单调的线性上升或下降趋势。
比如:我们经常需要探索暴露剂量、疾病严重程度与临床转归之间的量效关系。当数据呈现“单向有序”时,普通卡方检验无法体现这种递增或递减的生物学规律/干预措施,此时必须采用趋势卡方检验(Trend Chi-Square Test,在 SPSS 中称为线性和线性组合)。
A. 必须满足的基本条件:
观测独立性:每个受试者只能归属于交叉表中的一个格子。
变量属性:
一个变量为有序多分类变量(通常作为分组自变量,如:分层诊疗中的风险分级:低危/中危/高危)。
另一个变量为二分类变量(通常作为临床转归因变量,如:有效/无效)。
样本量要求:总样本量 N ≥ 40。
B. 满足条件的正面示例:
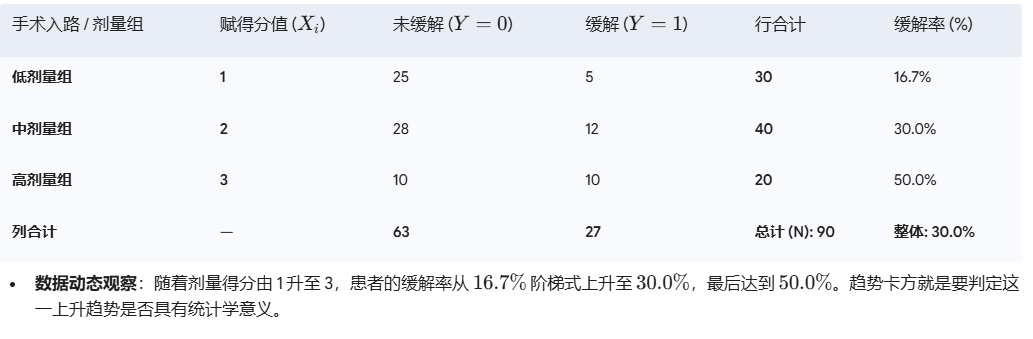
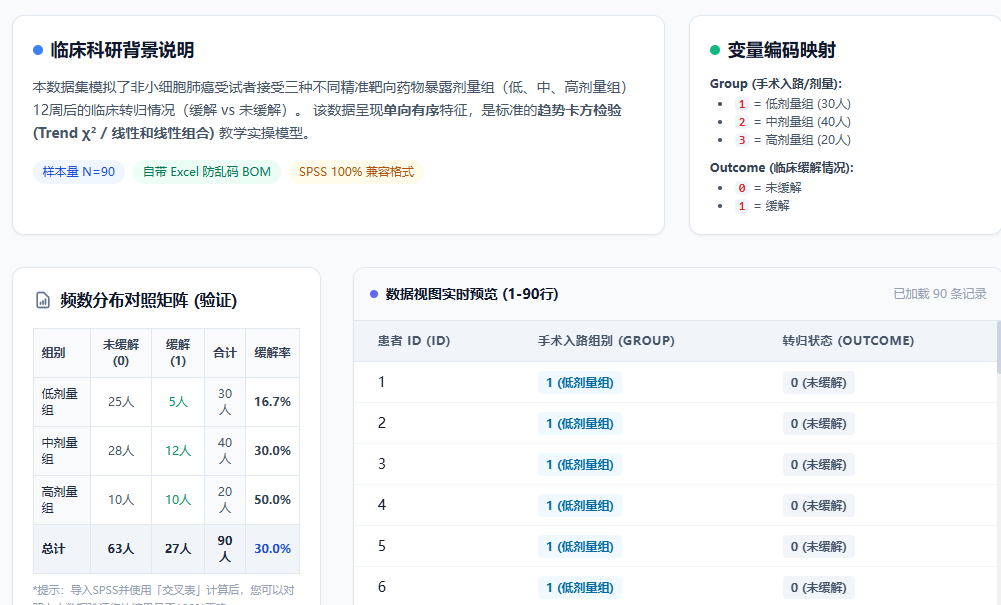
研究背景:为验证“双维融合的精准分层诊疗体系”对非小细胞肺癌受试者的分流增效作用,研究团队根据基因表达谱与临床分层,将受试者分为三种靶向药物暴露剂量组(低、中、高剂量组,自变量为有序多分类),观察其 12 周时的临床缓解情况(分为:缓解、未缓解,因变量为二分类)。
数据特征:自变量(药物剂量)具有低、中、高的有序递增属性;因变量(临床缓解)为二分类。研究目的是探究临床缓解率是否随着药物剂量的增加而呈线性上升趋势。
判定:完全满足趋势卡方检验的适用条件。
C. 不满足条件的负面示例(错用普通卡方或错用非参数):
在临床实际研究中,若强行对以下两类数据使用趋势卡方检验,将导致完全错误的统计结论:
反面案例 1:非单调趋势数据(倒U型/非线性量效关系)
研究背景:探究某种新型免疫调节剂的使用剂量(低、中、高剂量)与患者产生严重不良反应(是/否)的关系。
数据情况:低剂量组不良反应发生率为 5%;中剂量组上升至 45%;但由于高剂量触发了免疫耐受机制,高剂量组的不良反应发生率反而下降至 8%。数据呈现显著的“倒 U 型”曲线,而非单调递增或递减。
为什么不满足:趋势卡方检验的基本假设是单调线性趋势(等距得分线性相关)。如果强行在此案例中套用趋势卡方,由于高低两端数值的抵消,计算出的趋势卡方值极小,极易得出 \(P > 0.05\) 的错误结论,从而漏诊了中剂量组存在高危不良反应的真实临床风险。
纠正策略:应改用普通的 Pearson R×C卡方检验以证实组间差异,或引入非线性拟合模型。
反面案例 2:自变量不具备“有序等级”属性(无序分类资料)
研究背景:评估三种不同的手术入路(前路、后路、联合入路,自变量)对脊柱骨折大鼠术后 12 周植骨融合率(融合/未融合,因变量)的影响。
数据情况:三种手术入路在临床上属于平行的工艺选择,不存在“前路 < 后路 < 联合”的阶梯式递增或轻重等级逻辑。
为什么不满足:自变量属于无序分类变量。如果强行指定“前路=1,后路=2,联合=3”并进行趋势卡方检验,其卡方值和 P值将完全取决于你人工录入数据时对这三个组别的排序先后。这不仅违背了临床常识,也使统计学结果失去了科学客观性。
纠正策略:必须改用标准的 Pearson R ×C 卡方检验进行平行比较。
04.3.2 核心概念:为什么趋势卡方能释放“自由度”?
A. 普通卡方的软肋
对于 3 ×2的表格,普通卡方检验的自由度为:
df = (R - 1) × (C - 1) = (3 - 1)×(2 - 1) = 2这 2 个自由度意味着软件在计算时,允许三组的阳性率呈任何无序波动(如“高-低-中”或“低-高-低”)。
B. 趋势卡方的本质:线性和线性组合(Linear-by-Linear Association)
趋势卡方检验通过对有序变量的各个等级赋予一组等距得分(Scores,如低=1,中=2,高=3),将表格转化为两个变量之间的线性相关分析。
它的自由度始终固定为 df = 1。
自由度从 2 缩减到 1,意味着将所有的统计学检验效能全部聚焦于“是否存在单调线性趋势”这一个方向上。因此,它的敏感度(Power)远高于普通卡方。
04.3.3 趋势卡方的直观计算模型
04.3.4 SPSS 演示实战步骤
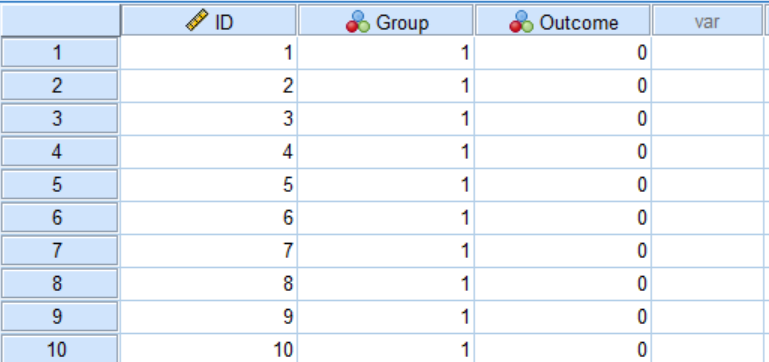
A 示例说明与数据录入:
B SPSS 详细操作流程
第一步:SPSS 变量视图确认
在粘贴或导入数据后,请先切换到 变量视图 (Variable View) 检查属性:
Group(手术入路/剂量组):
值 (Values) 标签:配置 1 = “低剂量组”,2 = “中剂量组”,3 = “高剂量组”。
测量 (Measure) 属性:设置为 有序 (Ordinal) 或 名义 (Nominal)(SPSS 交叉表均能识别)。
Outcome(转归状态):
值 (Values) 标签:配置 0 = “未缓解”,1 = “缓解”。
测量 (Measure) 属性:设置为 名义 (Nominal)。
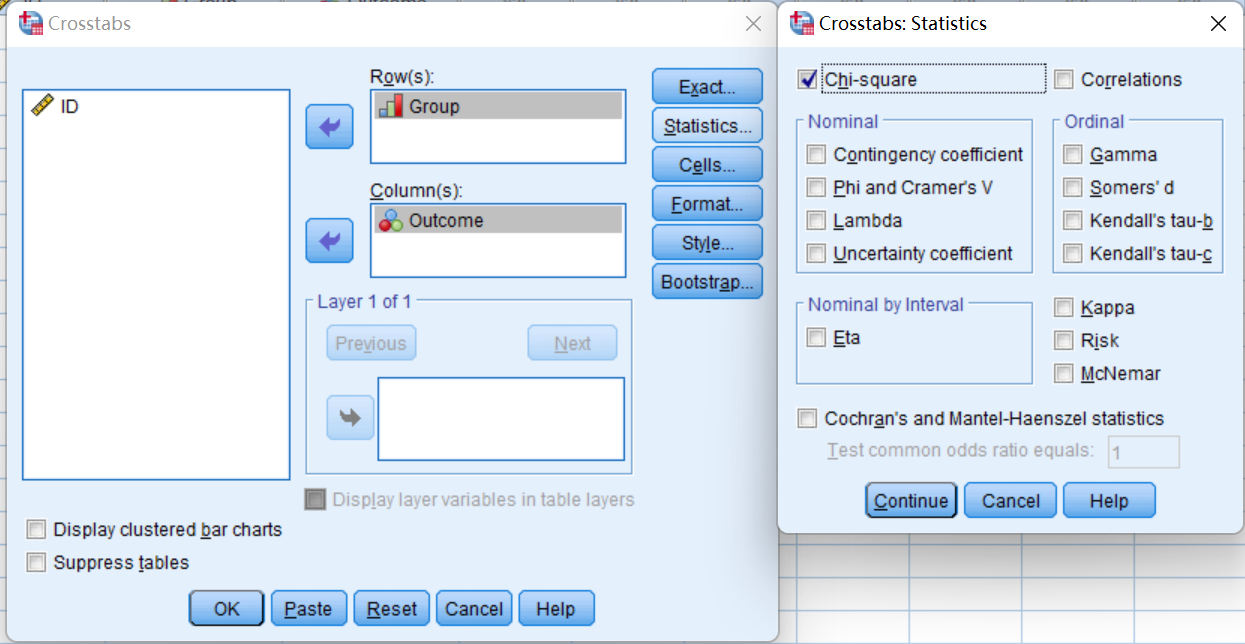
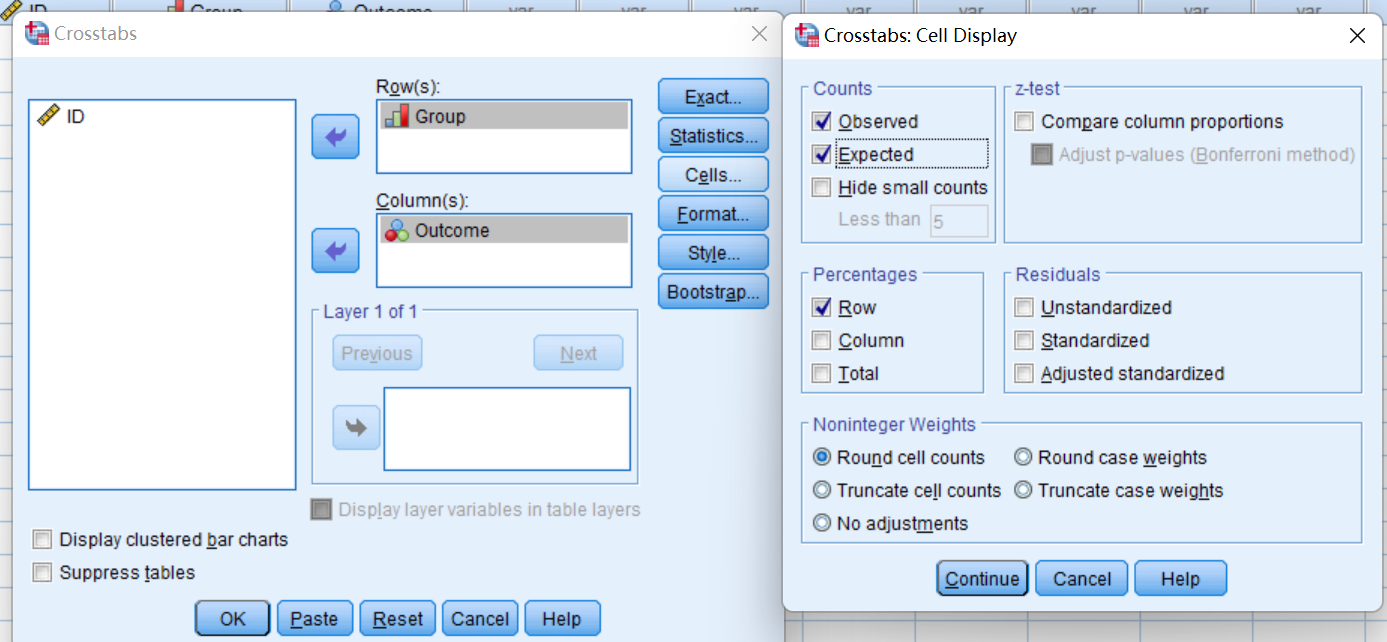
第二步:进入核心模块: 点击顶部菜单:分析 (Analyze) ──► 描述统计 (Descriptive Statistics) ──► 交叉表 (Crosstabs...)。
变量布局:
将 手术入路组别 [Group] 选入 行 (Row) 框中。
将 转归状态 [Outcome] 选入 列 (Column) 框中。
勾选卡方统计量:
点击右侧 “统计 (Statistics...)” 按钮。
勾选 卡方 (Chi-square)(趋势卡方的指标隐藏在卡方输出包中)。
点击 继续 (Continue)。
勾选行百分比(核心:用于汇报缓解率):
点击右侧 “单元格 (Cells...)” 按钮。
在“百分比 (Percentages)”区域下,勾选 行 (Row)。
点击 继续 (Continue),最后点击主窗口的 确定 (OK)。
第三步:SPSS 输出结果全景解读
运行后,SPSS 输出窗口将给出两个最关键的核心表格,我们将它们一一拆解:
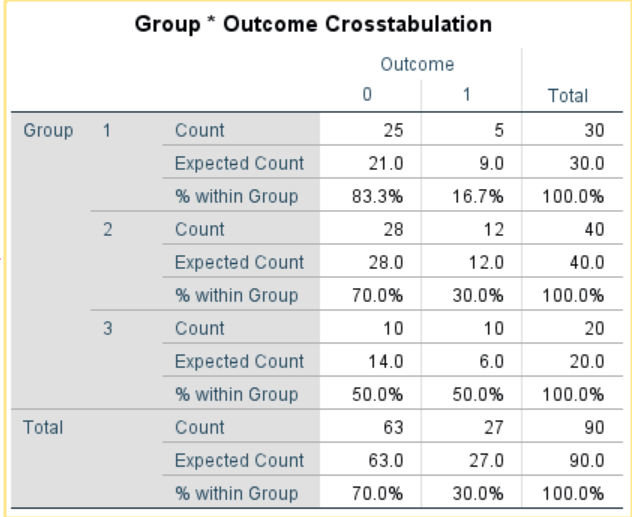
1. 第一张表:交叉表(Crosstabulation)
这张表用于描述数据的基础分布,也是论文中画三线表的数据来源。
低剂量组 (1):总数 30 人,未缓解 25 人,缓解 5 人。缓解率为:16.7%。
中剂量组 (2):总数 40 人,未缓解 28 人,缓解 12 人。缓解率为:30.0%。
高剂量组 (3):总数 20 人,未缓解 10 人,缓解 10 人。缓解率为:50.0%。
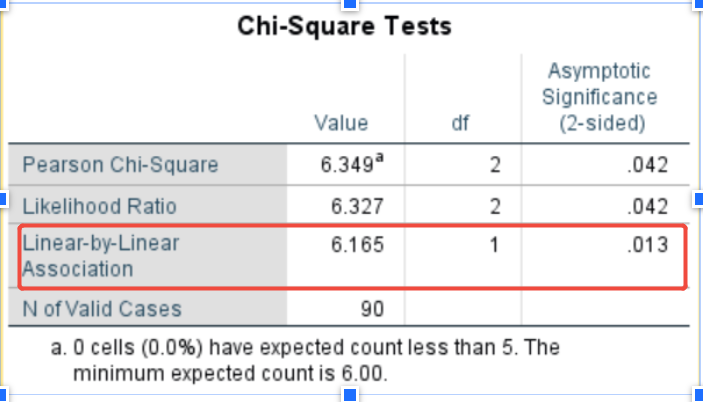
1. 第二张表:分析结果——(Linear-by-Linear Association)
04.3.5 注意事项
1:趋势卡方检验是否需要进行事后两两比较?如果需要,选择什么?
结论:不需要,也绝不能进行事后两两比较。
事后两两比较(Post Hoc Comparison)的前提是“整体假设检验的自由度 df > 1”(例如普通 3 × 2卡方,自由度为 2,我们不知道是哪两组之间有差异,所以需要两两比对)。
但趋势卡方检验(线性和线性组合)的自由度固定为 df = 1。
它的研究假设是:“随着自变量等级的升高,因变量的率呈现单调线性变化”。
这是一个整体的、线性的量效关系判定(类似于线性回归中的斜率是否为 0)。既然斜率只有一个,它要么显著,要么不显著,不存在“哪两点之间有斜率”的问题。因此,趋势卡方在逻辑上没有两两比较的概念。
如果学员在汇报趋势卡方 P < 0.05 后,又去做了组间的两两比较,这在方法学上属于严重的概念冲突(逻辑自相矛盾),变成了局部平行比较(如:低 vs 中,中 vs 高)。这会把原本有序的剂量强行割裂,抹杀了“趋势”本身。
2.趋势卡方检验是否需要计算和关注理论频数?
结论:需要关注,但它的限制比普通 Pearson 卡方要宽容得多。
普通的 Pearson 卡方有严格的“红线”:T < 5的格子不能超过 20%,且不能有T < 1。
而趋势卡方检验(线性和线性组合)的本质是基于单元格得分的 Pearson 相关分析。由于它利用了等级的顺序信息,其统计学稳健性极强。
基本红线:只要总样本量 N≥40,即使出现 T < 5 的格子超过了 20%,趋势卡方检验的结果依然是完全可信和成立的。
极端限制:只有当总样本量 N < 40,或者出现了极其极端的 T < 1时,趋势卡方的渐进分布才会失真。此时才需要考虑合并相邻的自变量组别,或者改用精确概率法。