定义与适用范围
卡方检验(Chi-square test)是一种假设检验方法。在常见医学统计教材的分类中,它通常归入非参数方法,主要用于分析分类变量,以统计两个及两个以上样本的实际观测值与理论推断值之间的拟合程度。
其核心思想是比较实际观察到的频数与在某一理论假设下应当出现的频数。在独立性检验中,理论假设通常是“两个分类变量相互独立”。如果观察频数与理论频数偏离较大,说明变量之间可能存在关联;偏离较小,则现有数据尚不足以否定独立假设。
基本原理
设两个分类变量 A 和 B 分别有 r 个和 c 个类别,交叉后形成 r×c 列联表。每个单元格都有一个观测频数 O 和一个在独立假设下计算得到的理论频数 T。
其中,Oij 是第 i 行、第 j 列单元格的观测频数,Tij 是对应的理论频数。原讲义中这一符号曾写作 Qij,此处按卡方检验的通用记号统一为 Oij。
χ² 值越大,观察频数与理论频数的偏离越明显;χ²=0 表示观察频数与理论频数完全一致。日常所说的“卡方检验”通常指 Pearson 卡方检验,但在 2×2 表中还需要根据样本量与理论频数判断是否使用 Yates 连续校正或 Fisher 精确检验。
常见分类资料概览
以下内容完整保留原讲义对卡方检验常见使用场景的概览,用于帮助理解整个课程体系;其中只有第一类属于本页的具体分析对象。
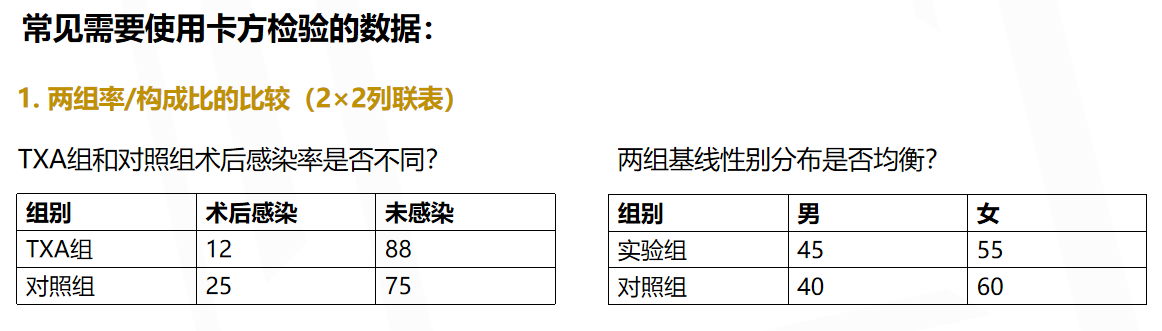
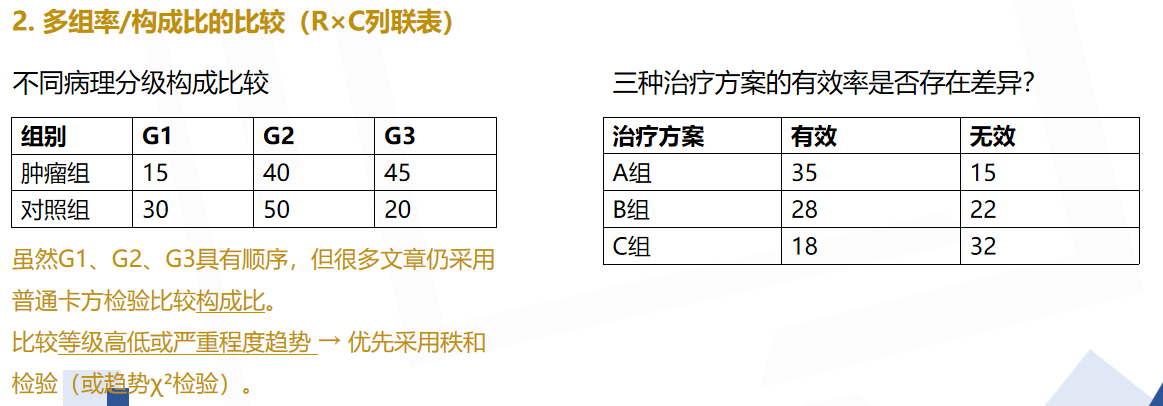
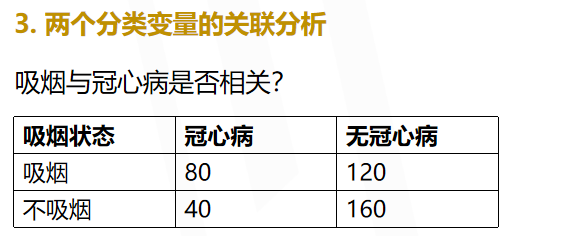
原始数据设计
示例问题:比较两种靶向维持治疗方案 A 与 B 用于非小细胞肺癌患者后,患者死亡率是否存在差异。
有逐例原始数据时,每一行代表一名研究对象,至少包括:个体编号 ID、组别 group 和二分类结局(例如死亡=1、未死亡=0)。
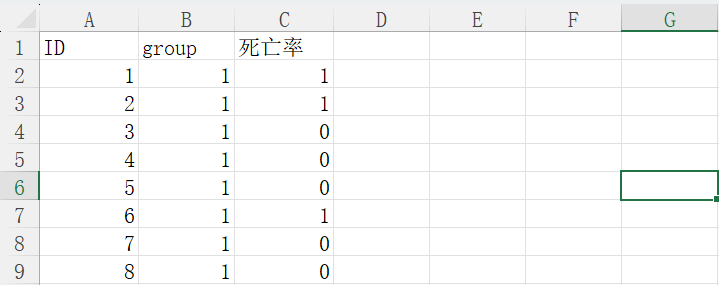
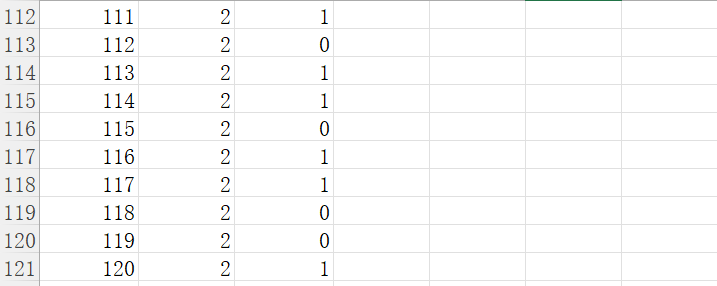
在不知道或不需要录入逐例原始数据时,也可以只输入每个组合对应的频数;频数输入法见 04.1.8。
SPSS 工作流
04.1.5.1 打开已有数据表
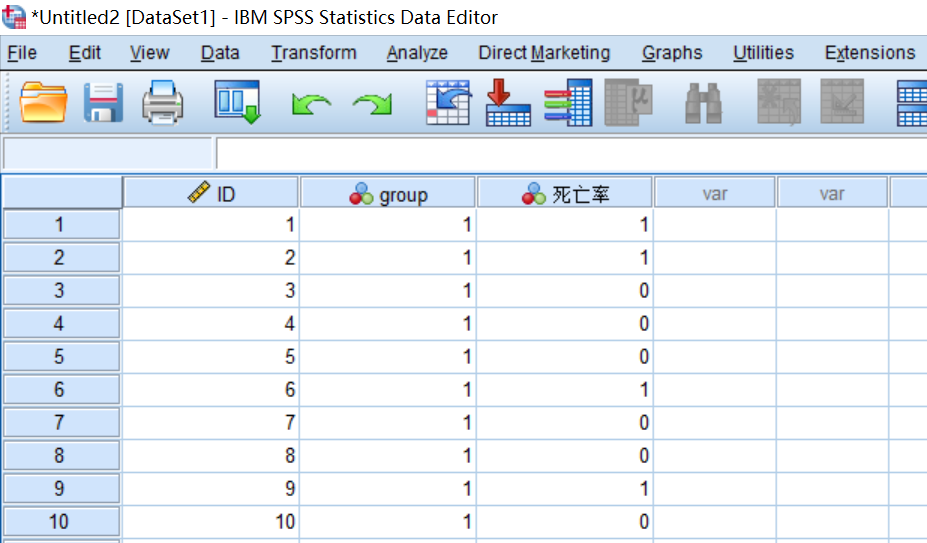
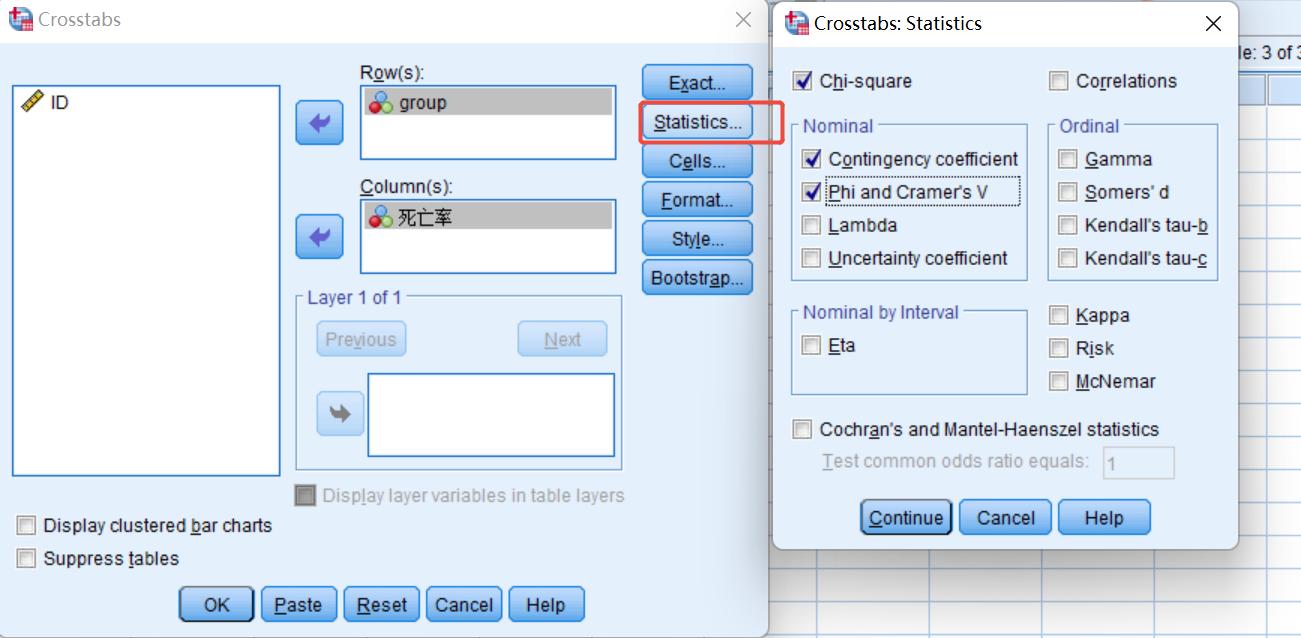
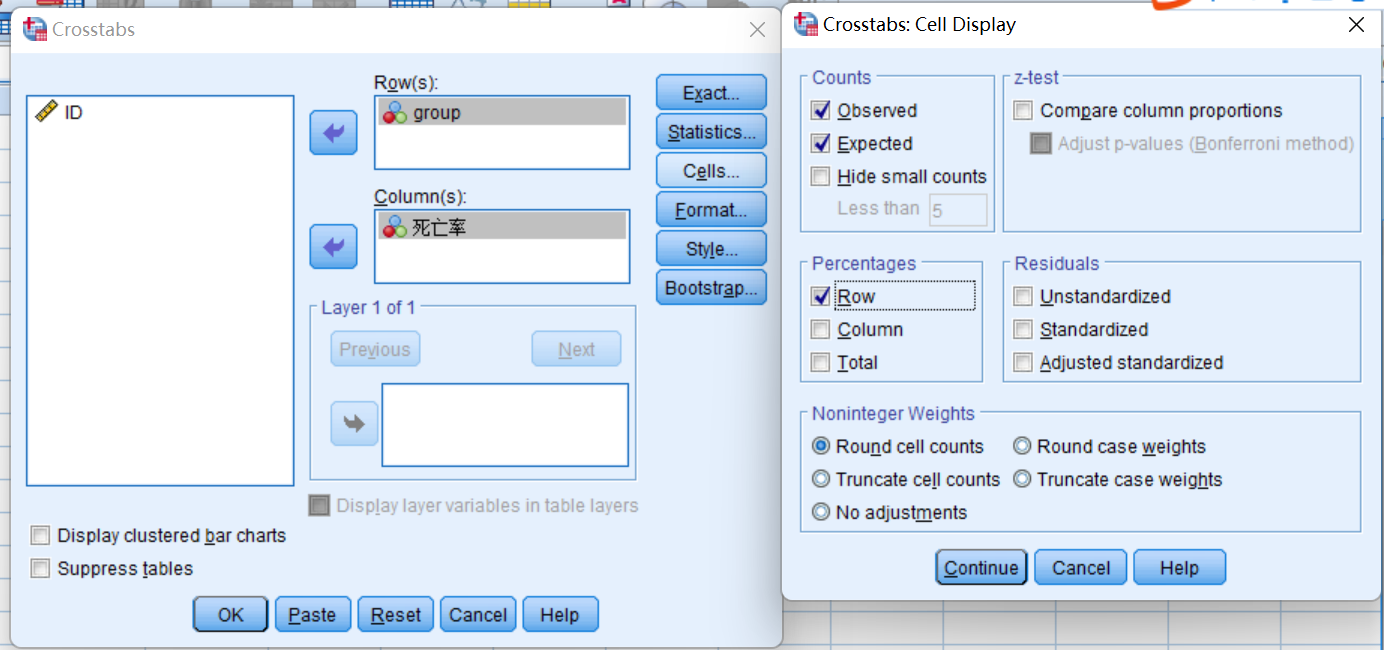
04.1.5.2 建立交叉表并选择统计量
结果解读与方法选择
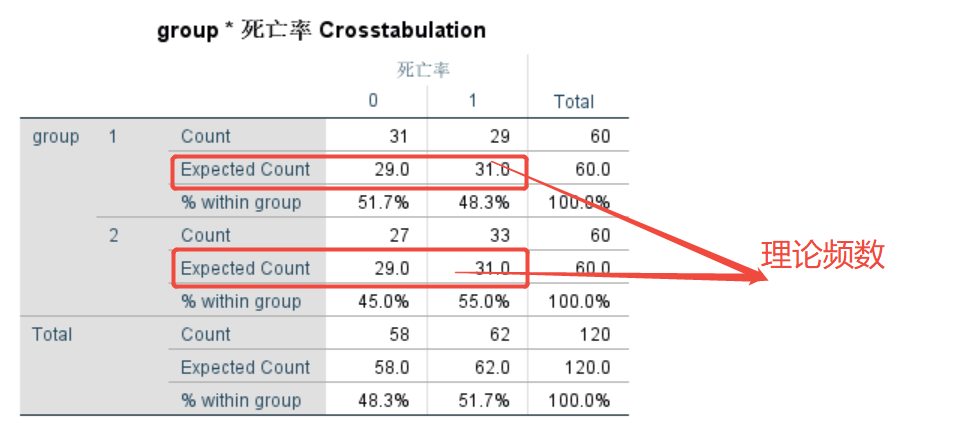
先查看 Crosstabulation 表中的观察频数、理论频数和组内百分比,再根据总样本量 N 与最小理论频数 T 确定应读取哪一行检验结果。
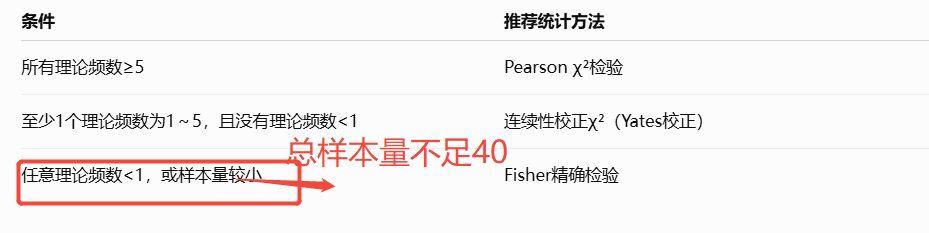
| 2×2 表条件 | 读取或采用的方法 | 解释要点 |
|---|---|---|
| N ≥ 40 且所有 T ≥ 5 | Pearson χ² | 读取 Pearson Chi-Square 行的双侧 P 值 |
| N ≥ 40 且存在 1 ≤ T < 5 | Yates 连续校正 χ² | 读取 Continuity Correction 行 |
| N < 40 或存在 T < 1 | Fisher 精确检验 | 读取 Fisher's Exact Test 的双侧精确 P 值 |
如果采用 Fisher 精确检验,输出重点是精确 P 值,不报告 Pearson χ² 统计量作为 Fisher 的检验统计量。
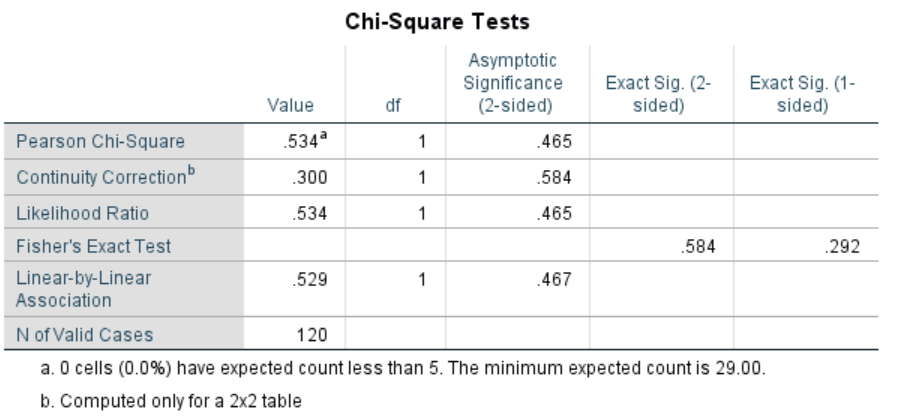
P < 0.05:拒绝“组别与结局相互独立”的原假设,认为两组率或构成比的差异具有统计学意义。
P ≥ 0.05:现有数据不足以拒绝原假设,不应表述为“证明两组完全相同”。
效应量
统计学显著不等于关联很强。2×2 表在报告 P 值之外,还可以报告 Phi 系数,帮助说明组别与结局的关联强度。
| Phi | Interpretation |
|---|---|
| < 0.10 | Negligible(可忽略) |
| 0.10–0.29 | Small(小效应) |
| 0.30–0.49 | Medium(中等效应) |
| ≥ 0.50 | Large(大效应) |
示例:A 组死亡率为 10.0%,B 组死亡率为 28.3%;Pearson χ²=5.84,P=0.016,Phi=0.22。可以解释为:两组死亡率差异具有统计学意义,但组别与死亡结局的关联强度较弱(小效应)。
无原始数据时的频数输入法
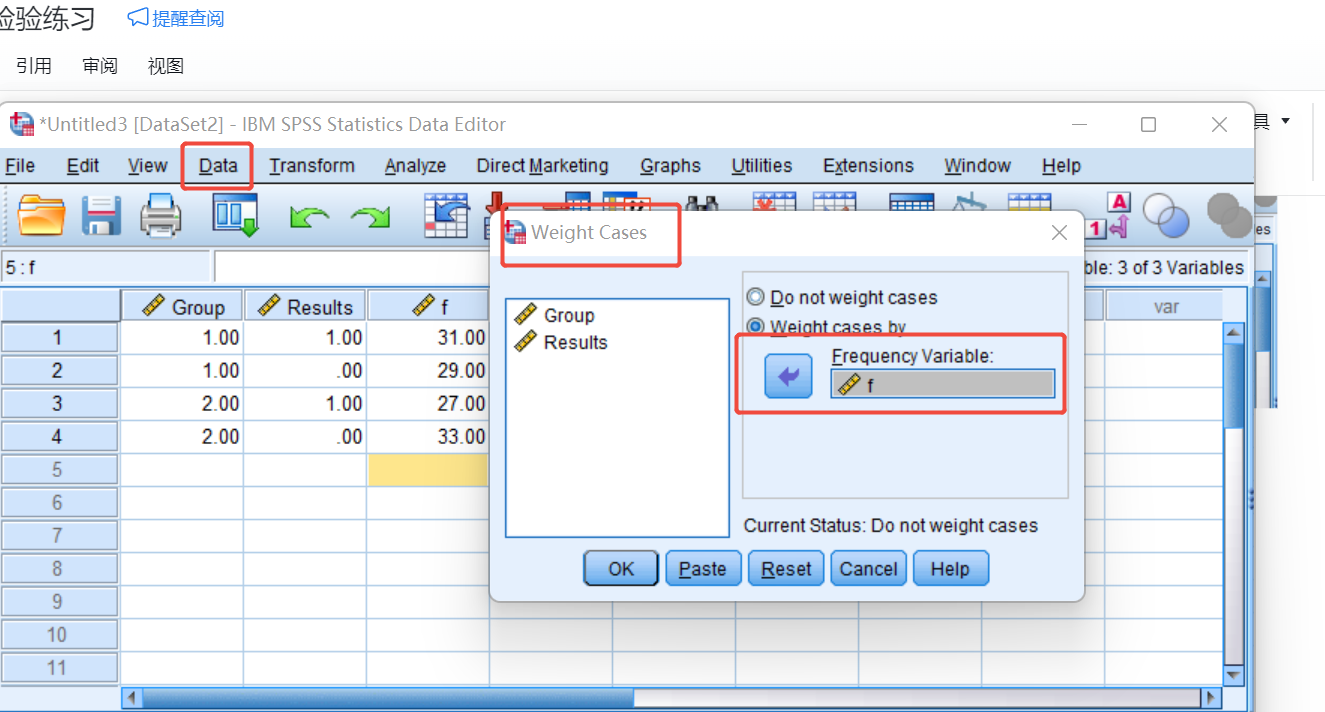
如果手头只有 2×2 表中的四个频数,可将每一种“组别 × 结局”组合录入一行,并增加频数变量 f。
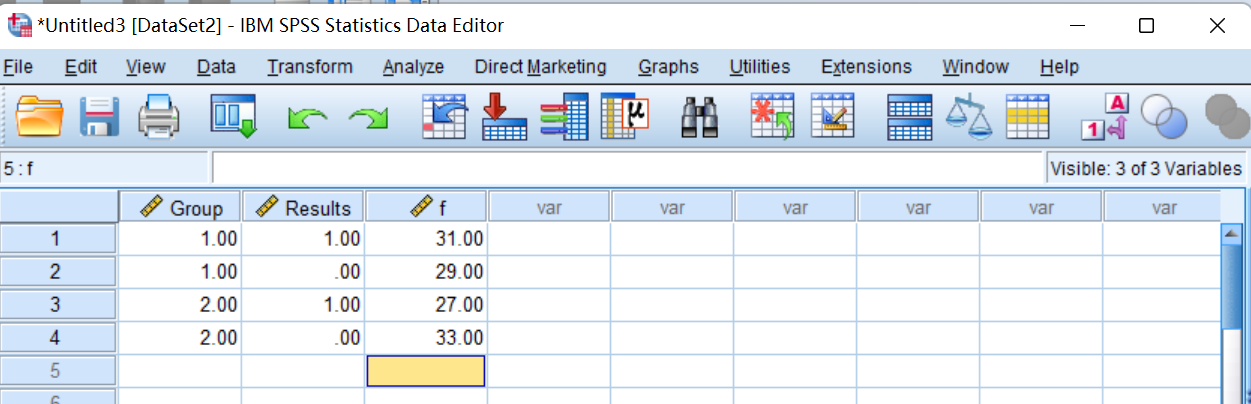
分析前必须先加权频数,之后的 Crosstabs 操作与逐例数据一致。
结果报告模板与核查
Pearson χ² 示例:A 组死亡率为 10.0%,B 组为 28.3%。两组死亡率差异具有统计学意义(Pearson χ²=5.84,df=1,P=0.016);Phi=0.22,提示关联强度较弱。
Fisher 示例:由于样本量或理论频数不满足 Pearson χ² 的适用条件,采用 Fisher 精确检验;两组率的差异……(双侧精确 P=…)。
提交结果前核查
- 研究对象是否确为两组独立样本,而不是配对或重复测量?
- 结局是否为二分类,交叉表是否确为 2×2?
- 是否检查了总样本量 N 和每个格子的理论频数 T?
- 是否读取了与条件相符的检验行,而不是固定读取 Pearson 行?
- 是否同时报告各组 n/N(%)、检验方法、统计量、自由度、P 值及效应量?
本页在完整保留原讲义文字、表格含义和 SPSS 截图的基础上,调整为网站课程编号,并补充分页边界、理论频数公式、方法选择表、规范报告模板与核查项。